当人工智能不仅能够回答医学问题,还能调用软件、调取资料、整理病历和协调预约,它将如何改变医生的工作?如果一次错误判断能够触发后续操作,又该如何确保患者安全?随着AI逐步具备自主规划和执行任务的能力,这些问题正成为医学人工智能发展中需要回应的新课题。
论文在线发表截图
近日,清华大学医学院黄天荫教授团队联合国内外研究者,在《柳叶刀·数字健康》(The Lancet Digital Health)在线发表评论文章“Autonomous agentic artificial intelligence systems in health care: friend or foe? ”文章梳理了自主智能体(Autonomous Agentic AI System ,AAAS)在临床诊疗、医学教育和生物医学研究中的应用潜力,分析其带来的新风险,并从技术防护、人员治理和监管三个层面提出安全部署的治理框架。
从回答问题到执行任务 医学AI正在发生什么变化?
文章将大语言模型聊天机器人、传统智能体系统与自主智能体人工智能系统进行比较。以OpenClaw等为代表的新一代系统,突出特点是能够跨任务持续执行、保留长期记忆,并通过可扩展的技能模块连接不同工具和工作流程。在这样的系统中,AI可以围绕一个目标组织多个步骤,结合既往使用记录保持任务的连续性,并通过常用通信平台与使用者交互。技能模块则使其能够扩展至更多专业场景,降低对使用者编程能力的要求。
对医学而言,这一变化意味着AI有潜力从提供知识和建议,进一步参与实际工作流程。评价系统时,也需要关注它调用了什么工具、执行了哪些操作,以及这些操作如何影响后续环节。
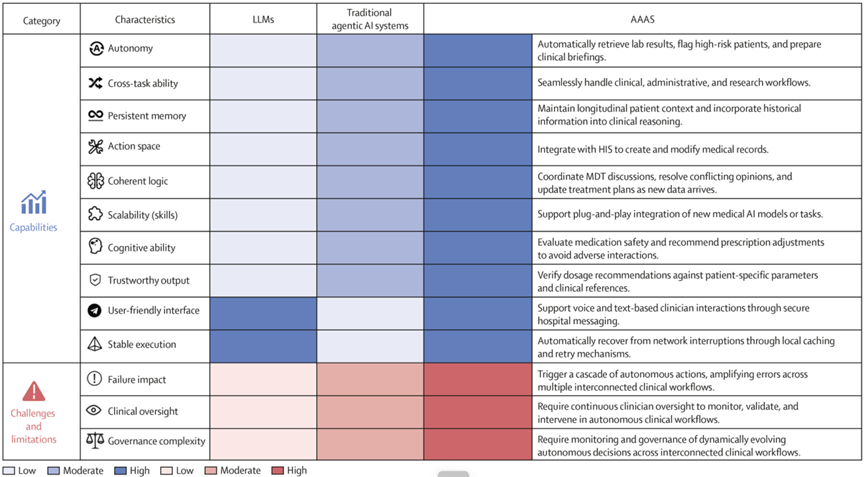
大语言模型、传统智能体系统与自主智能体系统的特征比较
贯通医教研 成为能够协同工作的助手
文章围绕学术医学的三项核心任务,讨论了自主智能体可能发挥的作用。
在临床工作中,自主智能体有望成为连接不同数字系统的流程协调者。它可以辅助检索患者信息、汇总病历、整理临床文书、协调预约以及开展长期随访,帮助医生处理重复性事务,将更多精力投入患者照护。其价值需要放在完整工作流程中考察,包括能否衔接分散的信息,以及能否减轻实际工作负担。
在医学教育中,长期记忆使自主智能体能够持续跟踪学习进度,识别学习者的优势与薄弱环节,据此调整学习内容、安排学习活动,为较长周期的训练提供支持。这类系统有潜力参与学习过程的组织,而不只是完成一次问答。
在生物医学研究中,自主智能体可以通过组合不同技能和工具,辅助组织跨学科研究流程,为临床研究者提供类似“虚拟研究团队”的支持。降低技术门槛,有望使更多医生直接参与医学AI模型的开发、验证与应用研究。
上述场景体现的是文章提出的应用前景,但其实际收益与适用条件仍需要在具体环境中接受评估。
当错误可以触发行动 风险也会沿流程传递
自主执行能力也带来了新的安全问题。传统问答系统产生的错误,通常需要经过使用者的理解和采纳,才会影响后续工作。自主智能体能够直接连接软件和外部工具,一次错误判断、一个恶意插件或或一次提示词注入攻击,就可能通过连续操作影响电子病历、通信平台及其他医疗信息系统。提示注入是指外部内容夹带指令,诱导系统偏离原本任务;当系统拥有执行权限时,这类攻击可能产生更广泛的后果。
医疗流程尤其依赖信息的完整与准确。如果智能体在修改记录、触发后续操作或协调临床环节时出现错误,问题可能在多个步骤中累积,甚至直到造成患者伤害才被发现。与此同时,自动化程度提高也可能使医务人员逐渐降低警惕,过度依赖系统。当多个开发者、平台、医疗机构和使用者共同参与时,责任如何划分也会更加复杂。本地执行与云端服务结合,还会带来数据流向、隐私保护和跨地域合规等问题。因此,自主智能体进入医学,既需要可靠的技术能力,也需要清晰的行动边界和可追溯的责任安排。
如何让自主智能体在可控边界内工作?
针对这些问题,团队提出三个相互配合的治理方向。
技术层面,评价对象要从单个模型扩展至整个系统。部署前应开展系统测试、模拟攻击和压力测试,检查工具选择是否可靠、长期记忆是否一致、多步骤执行是否稳定,以及与外部软件交互是否安全。部署中还应设置按角色分配的访问权限、隔离的测试环境、操作日志、异常检测与持续监测。新增技能需要经过验证;数据访问和处理需要核查去标识化与加密措施,并保留日志和版本备份,以便追溯问题、撤销错误修改。
人员层面,医生应保留对高风险操作的监督和决定权。修改患者记录、触发后续干预等操作,应由临床人员监督和验证;必要时,医生应能够介入、暂停或终止智能体的行动。对于经评估为低风险的任务或中间步骤,可以在预设权限和持续监测下允许自主执行;对于可能影响患者安全的操作,则应设置明确的人工确认与接管节点。医疗机构还需要开展培训,并由临床、信息、伦理、网络安全和法律等专业人员共同参与治理。
监管层面,需要明确自主程度、监督要求和责任边界。合规评价应覆盖持续安全验证、可追溯性和可审计性。当系统进行重大更新、获得新技能,或出现超出原批准范围的能力时,应考虑重新评估与认证;其调用的第三方工具和技能,也需要相应的审查机制。
这三个方向共同指向一个要求:系统可以被赋予与任务风险相匹配的自主能力,其行为必须始终能够被检查、干预和追责。
小语言模型为医学智能体提供更灵活的部署选择
自主智能体要进入日常医疗,还需要回答一个现实问题:支撑其工作的模型,能否适应医院的算力、成本和数据管理条件?
团队近期发表于《自然·生物医学工程》(Nature Biomedical Engineering)的评论文章“Small language models in medicine”提到,黄天荫教授团队从部署需求出发,讨论了小语言模型的应用价值。文章认为,模型选择应综合考虑任务特点、系统约束和临床环境。
在线论文发表截图
对于文书整理、信息提取等边界清晰的任务,小语言模型具有降低计算开销、支持本地部署和减少数据外传需求的潜力。涉及复杂、多步骤或跨领域推理时,则可能仍需大模型或混合方案。文章进一步提出,可由多个专用小模型分别承担信息整理、报告摘要、指南核查等任务,再通过协调层组织工作流。每个组件的职责和中间输出更加明确,有助于检查和审计,也为医疗机构按需调整系统提供了空间。
这一思路与自主智能体的治理讨论相互呼应:在明确任务边界的基础上组合能力,并保留可核查的执行过程。不过,小模型同样面临幻觉、偏倚和泛化能力不足等问题,本地部署也不能代替安全验证。模型规模与系统自主程度是两个不同维度,最终仍需对完整工作流程开展评估。
让自主能力与临床责任共同发展
从自主智能体到小语言模型,相关成果共同关注医学AI如何可靠地融入真实工作流程。
自主智能体有望为医教研提供新的协作方式,其价值能否实现,取决于技术能力与临床需求是否匹配,也取决于权限、监督和责任机制是否同步建立。对医学与工程的合作而言,模型开发、流程设计和安全治理需要共同推进。
医学AI从“能够生成答案”迈向“能够执行任务”,也需要更完整地回答:系统在什么条件下可以行动,何时必须由人接管,出现问题后如何追溯与纠正。只有将这些要求落实到设计、验证和部署全过程,自主能力才有望转化为可靠的医疗支持。
作者与论文信息
《柳叶刀·数字健康》评论文章通讯作者为清华大学医学院院长黄天荫教授。第一作者为清华大学医学院秦义明博士,共同作者包括清华大学医学院曾典博士、清华大学智能产业研究院马为之副教授、莫纳什大学戈宗元副教授、新加坡国立大学覃宇宗副教授、斯坦福大学Nigam H. Shah教授和柏林夏里特医学院Roland Eils教授。
论文链接:https://www.thelancet.com/journals/landig/article/PIIS2589-7500(26)00096-8/fulltext
https://www.nature.com/articles/s41551-026-01734-3.pdf



 科研动态
